
Context.dev
Eine einzige API, die Live-Webdaten scraped, crawlt und anreichert - als strukturierte Formate für Agenten und Apps.
Community:


Produktübersicht
Was ist Context.dev?
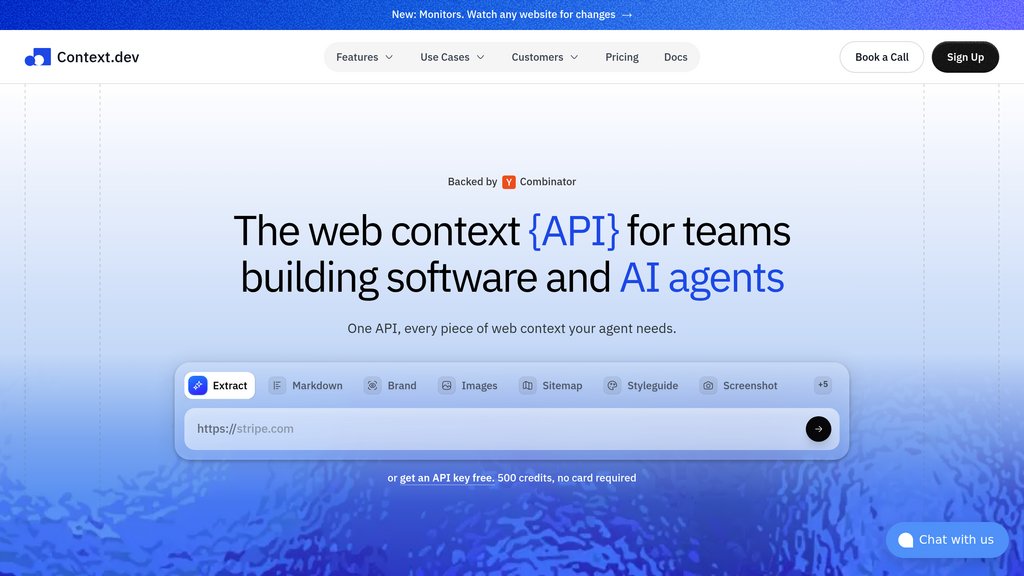
Context.dev ist eine Web-Context-API, die Softwareteams und KI-Agenten Echtzeitzugriff auf das offene Web ermöglicht, ohne eine eigene Scraping-Infrastruktur aufbauen oder pflegen zu müssen. Sie verwandelt jede URL in sauberes Markdown oder HTML, löst Domains und unübersichtliche Transaktionsbeschreibungen in typisierte Unternehmens- und Markenprofile auf und liefert Logos über einen Image-Endpoint ohne Einrichtungsaufwand. Die von Y Combinator unterstützte Plattform ersetzt einen Flickenteppich aus Scraping-Anbietern durch eine einzige typisierte Schicht und wird von Teams wie Mintlify und daily.dev genutzt, um RAG-Pipelines, Onboarding-Abläufe und agentische Workflows mit Live-Daten zu versorgen.
Hauptfunktionen
Web Scraping & Crawling
Wandelt jede beliebige URL oder eine komplette Sitemap in sauberes, LLM-taugliches Markdown oder HTML um - inklusive JavaScript-Rendering und Anti-Bot-Umgehung ohne Mehrkosten.
KI-basierte strukturierte Extraktion
Definieren Sie ein eigenes Schema und extrahieren Sie mit KI-gestütztem Parsing genau die benötigten Felder - etwa Preisstufen oder Produktspezifikationen - von jeder beliebigen Seite.
Marken- und Unternehmensdaten
Löst eine Domain, E-Mail-Adresse oder Börsenkürzel in ein typisiertes Profil auf, mit Logos, Farben, Schriftarten, Branche, Mitarbeiterzahl und Umsatzschätzungen.
Logo Link
Binden Sie jedes Firmenlogo mit einem einzigen Image-Tag ein, ausgeliefert über ein globales CDN - ohne API-Key oder Backend-Aufruf.
Auflösung von Transaktionsdaten
Verwandelt kryptische Händlerbezeichnungen wie Kontoauszugs-Codes in erkennbare Markennamen mit zugehörigen Metadaten.
Typisierte SDKs für mehrere Sprachen
Offizielle SDKs für TypeScript, Python, Ruby, Go und PHP ermöglichen es Teams, die API in wenigen Minuten in die meisten Tech-Stacks zu integrieren.
Anwendungsfälle
- Echtzeit-Grundlage für RAG : Halten Sie Suchindizes aktuell, indem Sie Sitemaps crawlen und frische Seiten in Embeddings umwandeln - ohne fragile eigene Parser.
- Web-Bewusstsein für KI-Agenten : Geben Sie autonomen Agenten Live-Zugriff auf Preisseiten, Dokumentationen und Changelogs, damit ihre Antworten das aktuelle Web widerspiegeln statt eines veralteten Trainingsstands.
- Automatisches Ausfüllen beim Onboarding : Füllen Sie Anmeldeformulare vorab mit Firmenname, Logo und Branche aus, die aus der geschäftlichen E-Mail-Domain des Nutzers stammen, um Abbrüche zu reduzieren.
- Fintech-Transaktionsanreicherung : Übersetzt rohe Zahlungsbeschreibungen in saubere Markennamen und Kategorien für Kontoauszüge, Budget-Apps oder Ausgaben-Tools.
- Sales- und CRM-Anreicherung : Reichert eingehende Leads automatisch mit Firmen- und Markendaten an, damit Vertriebsteams Accounts schneller qualifizieren können.
Häufig gestellte Fragen
Context.dev Alternativen

Zyte
KI-gestützte Web-Scraping-API und Datenextraktionsplattform mit fortschrittlichem Anti-Ban, Proxy-Management und skalierbaren Lösungen.

ScrapingBee
Eine Web-Scraping-API, die die Datenextraktion von Webseiten durch die Verwaltung von Headless-Browsern, Proxy-Rotation und KI-gestützte Datenextraktion vereinfacht und es Nutzern ermöglicht, dynamische und geschützte Seiten effizient zu scrapen.

Yutori
Autonome Web-Agenten, die alltägliche digitale Aufgaben bewältigen und Online-Inhalte überwachen, damit sich Benutzer auf das Wesentliche konzentrieren können.

Nimble
Umfassende Web-Datenplattform mit skalierbaren, konformen und Echtzeit-Datenpipelines sowie fortschrittlichen Automatisierungs- und Integrationsfunktionen.

ScrapeGraphAI
KI-gestützte Web-Scraping-Bibliothek, die Large Language Models und graphbasierte Pipelines für anpassungsfähige, mehrformatige Datenextraktion nutzt.

Thordata
Ethisches Proxy-Netzwerk mit über 60 Millionen Residential-IPs und umfassender globaler Abdeckung für Web-Datenerfassung und sicheres Surfen.

Scrappey
Eine umfassende Web-Scraping-API, die die Datenextraktion durch Bewältigung von Anti-Bot-Maßnahmen, rotierenden Proxies und CAPTCHA-Lösung vereinfacht.

Skyvern
KI-gestützte Browser-Automatisierungsplattform, die LLMs und Computer Vision nutzt, um komplexe Web-Workflows auf jeder Website zu automatisieren.